Codeforces Round 1040 (Div. 2)
목차

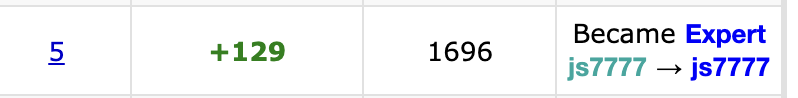
D가 진짜 어려웠다.. 전형적인 코드포스 애드 혹의 극치가 아닐까 생각한다.
A B C 실수 없이 빨리 풀어서 D를 1시간 동안 고민하면서 풀 수 있었고, E도 이해는 쉬워서 인터랙티브 문제였지만 결국 E1까지 맞출 수 있었다. 인생 최고 등수라서 기분이 좋다. 블루를 찍었다! 야호!
A — 00:03 AC#
당연히 이 최대인 것 같지만, 에 영향을 주지 않는 0을 에 넣으면 1이 나오게 된다.
의 모든 0을 1로 바꾸고 의 합을 구하면 최대 점수가 된다.
B — 00:12 AC#
어찌 되었든 배열에서 1부터 까지 가야 하기 때문에 최소 만큼의 비용이 든다. 따라서 비용이 보다 작으면 불가능하다.
중간에 직선으로 가다 왔다리 갔다리 하는 건, 배열에서 연속된 두 수의 합들로 표현될 수 있다.
예를 들어 로 를 한 번 좌우로 움직이고 5까지 갔다고 하자. 이는 직선일 때 비용 에 index 를 더해준 것과 비용이 같다.
그리고 더 큰 폭으로 좌우로 움직여도 이는 똑같다. 로 을 한 번 좌우로 움직이고 5까지 갔다고 하면, 직선일 때 비용 에 index 와 index 을 다 더해준 것과 비용이 같다. 결국 에 인접한 두 수들의 합들을 잘 더해서 에 도달하는 게 가능한지 보면 된다.
의 원소가 0부터 2까지밖에 없기 때문에, 인접합으로 가능한 건 0, 1, 2, 3, 4이다. 우리는 배열을 재구성할 수 있기 때문에, 특정 인접합이 나오지 않게 해서 에 도달하는 게 불가능하게 할 수 있다.
예를 들어 로 배열을 재구성하면, 0과 1의 합으로만 나타나는 인접합 1을 만드는 게 불가능하다. 따라서 인 경우에 불가능하게 만들 수 있다.
사실 그렇지 않으면 안 된다. 에서, 인접합 1을 만들 수 있으면 그 인접합을 번 더해서 를 만들 수 있기 때문이다.
인접합 1을 만들지 않으려면 0과 1을 분리해야 하기 때문에.. 사실상 나머지 0, 2, 3, 4는 막을 수 없다. 가 2 이상이면 2, 3, 4의 합으로 표현될 수 있음이 자명하기 때문에 결론적으로 이거나, 라면 불가능하게 할 수 있고, 나머지는 막을 수 없다.
C — 00:27 AC#
선택한 부분집합 에 사이클이 있다고 하자. 사이클을 이루는 간선 하나를 제거해도 는 변하지 않지만 은 커진다. 즉, 에 사이클을 포함하지 않아야 한다. 최소 스패닝 트리를 만드는 방식에서 착안해서, 최대 스패닝 트리? 를 만드는 느낌으로 하면 된다. 간선 가중치 순으로 정렬해서 큰 거부터 사이클 안 만들게 골라주는 느낌.
D — 01:19 AC#
로 반전시키는 것의 의미를 찾는 게 진짜 어렵다.
1. 번째 원소에 대해 할 수 있는 선택지는 를 유지하거나 로 바꾸는 것이다.
를 유지하면, 이고 인 쌍을 inversion pair로 안 만들고 놔둘 수 있다.
그와 동시에, 이고 인 쌍을 inversion pair로 만든다.
로 바꾸면, 이고 인 쌍들에서 가 되어 inversion pair로 만든다.
그와 동시에, 이고 인 쌍들에서 가 되어 inversion pair인 쌍들을 아닌 걸로 바꾼다.
2. 번째 원소에 대해 또는 를 선택하는 건 결과에 독립적으로 영향을 미친다.
일반성을 잃지 않고 이라고 하자. 라면, 기준으로 이고 인 쌍을 만들고, 기준으로는 가 포함된 쌍을 만들 수 없다. 따라서 각 쌍들은 서로의 범위에 영향을 끼치지 않는다. 즉, 독립적이다.
1번과 2번을 에 대해 적용시켜서 각각 에 대해 inversion pair의 개수를 최소로 한 것의 합이 답이 될 것이다.
실제로 구현할 때는 뒤죽박죽하게 식 정리를 해서 를 유지했을 때 inversion pair를 만드는 경우들을 계산했다.
에 대해 는 이고 여서 inversion pair를 만드는 개수
에 대해 는 이고 여서 inversion pair를 만드는 개수
이렇게 놓고, 로 바꿨을 때 inversion pair의 개수의 변화 를 구해서, 가 음수일 경우만 바꾸도록 하면 그 합이 답과 동치이다.
펜윅으로 와 를 구해주면 된다.
E1 — 02:13 WA#
이분탐색 짜는데 인 경우 따로 분기 작성을 안 해서 터졌다. 그거 말고도 아예 홀수 길이 처리에 대한 예외를 안 해준 것도 있다. 인터랙티브라서 테스트하기 너무 빡세요..
E1 — 02:35 AC#
550번이라는 쿼리 제한은 생각보다 널널하다. 단순하게 하나의 쿼리에 하나의 괄호만 판별하면 1000번이 필요하기 때문에, 550이라는 제한은 한 번의 쿼리에 적어도 괄호 2개를 판별해야 한다는 걸 의미한다. 그리고 굳이 E1 E2 E3로 나눠놓은 건.. E1에는 간단한 아이디어를 적용할 수 있지 않을까?
어차피 괄호 선택은 아무거나 할 수 있기 때문에 그냥 연속된 괄호라고 생각하면, 가능한 경우는 (), )(, )), ((으로 4개가 존재한다.
중요한 건, 이 4개의 쌍에 대해 각기 다른 고정된 결괏값을 내도록 하는 쿼리가 있는지이다.
다른 다양한 것도 있기야 하겠지만... 대회 당시에 찾은 쿼리는
aabbabab)이다. (, 는 값을 모르는 괄호 문자)
가 (), )(, )), ((인 경우일 때 각각 다른 값을 내놓기 때문에, 이걸 통해 구분할 수 있다.
()일 때 (())()())가 쿼리가 되어서 7로 응답한다.
)(일 때 ))(()()()가 쿼리가 되어서 6으로 응답한다.
))일 때 )))))))))가 쿼리가 되어서 0으로 응답한다.
((일 때 (((((((()가 쿼리가 되어서 1로 응답한다.
이렇게 하면, 500번의 쿼리로 모든 문자열을 알아낼 수 있다.
이제 중요한 건, 쿼리에서 )라는 괄호 문자가 쓰인다는 것이다. 이건 항상 고정되어 있어야 7, 6, 0, 1이라는 서로 다른 값이 , 에 의해서만 나올 수 있기 때문에, 결론적으로 적어도 )에 해당하는 문자를 한 개는 알아내야 한다는 것이다. 남은 50번의 쿼리만으로.
문제의 조건에 따르면 주어진 괄호 문자열이 모두 같은 문자로만 이루어져 있지는 않다. 즉, 적어도 )가 1개는 존재하고, (도 1개는 존재한다.
전체 문자열을 쿼리로 물어보면, 0 또는 자연수가 나올 것이다. 0이 나온다면, 문자열은 반드시 ))))....(((( 꼴이다. 따라서 1번째 문자가 )임이 자명하다. 그렇지 않다면 () 쌍이 적어도 1개 존재할 것이다. 쿼리에서 모르는 두 괄호 문자 , 만 사용해서 질문했을 때, 답에 따라 바로 특정되는 쿼리는 뭐가 있을까? 바로 로 질문했을 때 답으로 1이 나오는 경우이다. 이 경우 는 무조건 (이고 는 무조건 )이다.
이제 이 두 가지 사실을 이용해서, 전체 문자열에서부터 이분탐색을 할 수 있다. 대회 당시 썼던 아이디어 노트는 다음과 같다.
우선, 질의했을 때 답을 라고 하자. 주어진 괄호 문자열은 이고. (즉, 우리가 찾아야 하는 게 ) 의 1번째 문자를 , 2번째 문자를 ... 라고 하자. 의 길이는 이라고 주어졌다.
1차 목표: 정확히 )인 index 찾기.
만약 길이가 2인 문자열을 질의했는데 이라면 문자열은 반드시 ()이라는 걸 이용한다.
문자열 의 경우는 크게 2가지가 있다.
이다. 즉, RBS가 안에 없다.
이런 경우, 는 반드시
)))....(((이런 형태여야 한다. 즉, 이고, 이다. 그러므로 1차 목표를 달성할 수 있다. 이 경우 1차 목표 달성.이다. 즉, RBS가 안에 있다.
이런 경우, 이분탐색을 통해 알아낼 수 있다. 현재 문자열의 길이를 라고 하자.
I. 1부터 까지를 질의해보자. 이라면, 1부터 를 새로운 문자열로 잡고 다시 이분탐색을 한다.
만약 이라면,
II. 부터 까지를 질의해보자. 이라면 부터 를 새로운 문자열로 잡고 다시 이분탐색을 한다.
만약 이라면
분명 는 0보다 컸는데 둘 다 가 0이라는 건 두 부분에 의해 RBS가 잘렸다는 뜻. 즉, 와 로 분리되었다는 것이니,
이고 이다.
이렇게 이분탐색을 통해서, 문자열의 길이가 2가 될 때까지 반복하면, 그때 값이 1이 나오면 ()인 게 확정이 되니, 그걸로 (와 )의 index를 특정할 수 있다.
이분탐색이니 이 최대 1000이라서, 최악의 경우에도 50번의 질의 이내로 알아낼 수 있다.
이렇게 얻어진 index에서, (와 ) 문자의 위치를 각각 , 라고 하자.
2차 목표: 전체 문자열 구하기
이제, 이미 알고 있는 와 를 제외한 나머지 것들을 구해야 한다.
간단하게 이렇게 2개씩 짝지어서 구하면 된다.
어떤 문자인지 모르는 와 에 대해 질의를 다음과 같이 한다.
- 만약 이라면, 이고 이다.
- 이라면, 이고 이다.
- 이라면, 이고 이다.
- 이라면, 이고 이다.
이렇게 하면 한 번의 질의로, , 를 알 수 있으므로 최대 500번의 질문으로 모든 문자열을 알아낼 수 있다.
이렇게 모든 문자열을 알아내고, 합쳐서 !으로 답을 출력하면 된다.
인 경우 특수 로직으로 나눠야 한다.
우선, 이 3인 경우에는 각각 , , 라고 놓자.
를 한다.
만약 가 0이라면 이고, 이다. 를 알아보기 위해 를 하자. 만약 가 1이라면 이고, 가 0이라면 이다.
만약 가 1이라면 를 하자.
- 만약 가 1이라면 이고 이다. 를 알아보기 위해 를 하자. 만약 가 1이라면 이고, 0이라면 이다.
- 만약 가 0이라면 이고 이다. 를 알아보기 위해 를 하자. 만약 가 1이라면 이고, 0이라면 이다.
이렇게 하면 일 때 정답을 구할 수 있다.
자 이제 다음으로, 인 경우. 즉 이분탐색을 하다 길이가 3인 경우를 만났을 때이다.
각각 , , 라고 놓자.
를 한다.
만약 가 0이라면, 이 구간에선 더 이상 할 게 없다. 다음 구간으로 넘긴다. (만약 지금 구간이 1부터 일 때였다면, 부터 까지 구간으로 넘어가고, 만약 지금 구간이 부터 까지 구간이었다면, 이고 으로 정하고 이분탐색 종료하는 원래 로직을 따르면 된다.)
만약 가 1이라면 를 하자.
- 만약 가 1이라면 이고 이다.
(와)의 인덱스를 알아냈으니 이분탐색을 종료한다. - 만약 가 0이라면 이고 이다.
(와)의 인덱스를 알아냈으니 이분탐색을 종료한다.
댓글